
给机器学习系统课程做了一下中文翻译
在线阅读: MLSys 中文翻译 搞到网页上方便阅读。 原网页链接: MLSys 课程名称:复旦大学2025-2026春机器学习系统课程(尚笠老师)
[object_storage] 用来管多模态推理时图片之类文件的存储。原来这个段的 endpoint 只能写死一个地址,我提的 PR 让它也能写成 env::SOME_ENV_VAR,启动的时候从环境变量里读。这样内网地址、测试和生产的存储端点就不用都摊在配置文件里了。 当时提的 PR 是…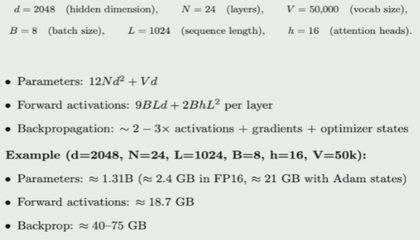
test_tokenizer 中 import resource 这个库只能在linux中使用,决定将核心代码拷贝到linux环境下进行测试。 而为了保证实现的正确性,在原来的windows环境下利用gpt撰写了 test_tokenizer_windows.py…cd 这样的广为人知的基础指令,直接看那些显著提升体验的东西。 用于查看磁盘空间。使用场景比如训模型会保存很多中间文件,可以这样看看需要清理哪些。 使用效果: 比如 fuse-overlayfs 是这个实例本身的存储, shared-nvme 是它的外接可持久化存储,使用率分别为 50% 和 40% 。 至于要看哪几个文件最大,可以和 ncdu…wandb.log 函数,记录 epoch,…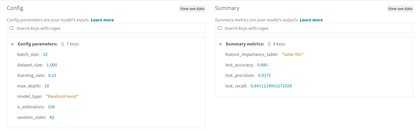


 posts
courses
cs61a
cs336
csapp
notes
agents
algo
ml
 LLM 估算 · 01 · 怎么估算参数量和训练 FLOPs
2026-03-03
LLM 估算 · 02 · 怎么估算训练的内存和计算需求
2026-03-12
用双卡 5090 训练 Qwen3-0.6B:从数学推理到 Agentic RL 的完整踩坑大集锦
2026-08-07
MiniTorch尝试复现了PyTorch的许多API
2026-01-05
结合nanovllm的FlashAttention和PagedAttention主要原理概述
2026-05-16
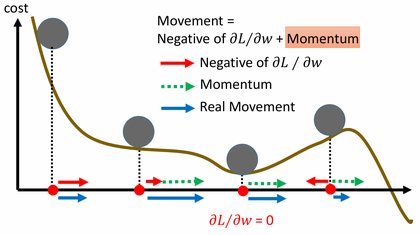
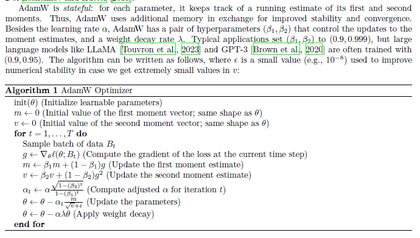
从SGD到AdamW,优化器怎么发展过来的?
2026-03-11
深度学习必将拥有一套科学理论 · 翻译
2026-08-11
从原始Softmax到在线Softmax
2026-04-09
给 tensorzero 提的第一个 PR:object_storage.endpoint 支持环境变量
2026-03-14
抓到一个会“假装训练”的 bug:TRL 1.9.2 续训 LoRA 时优化器是空的
2026-08-10
tools
reference
toy